asrbox,我的第一个长期稳定更新产品的开发全记录
ASRBOX,我的第一个长期稳定更新产品的开发全记录
2026 年 7 月 2 日,我清掉 ASRbox 的初始仓库,开始搭一个能真正跑通本地转写的骨架。那时我没有直接写“上传音视频、点击转写、导出字幕”的页面,而是先把一个已经跑通的本地语音工作台拆开,确认哪些结构可以复用,哪些只是另一个产品的历史包袱。
这篇记录按时间顺序整理从第一次 scaffold 到 11 月 10 日 v0.4.1 发布之间的开发过程。它不是功能清单,而是我在一个本地优先产品里,被模型路径、冻结运行时、任务生命周期、字幕版本、跨平台安装和发布流程一步步推着往前走。
这四个月里,仓库累计了 21 个 Git 标签,主分支有 221 个首父提交。几乎每碰到一个真实故障,我都会把模型、任务、发布和恢复路径再往前补一轮。
对我来说,本地优先不是一句口号。模型没有下载、原文件被移动、worker 卡死、Windows 升级残留旧依赖、翻译错位或 CUDA 不可用时,产品得能解释发生了什么,并留下可以恢复的路径。
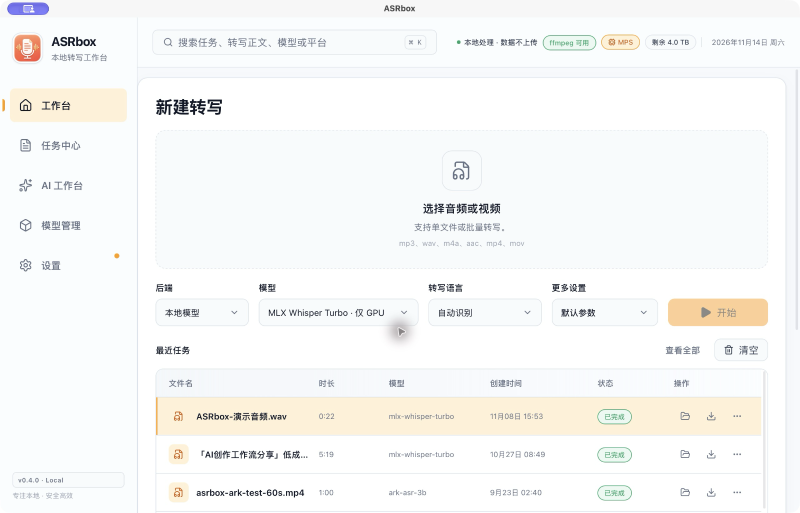
截图 01:本机 macOS 桌面版首页。这里的“本地处理 · 数据不上传”、模型选择和最近任务来自实际运行的桌面应用,而不是网页模拟图。
背景与起点
- 我第一个决定不是接多少个 ASR 模型,而是先拆解 Voicebox,确定桌面壳、共享 UI、FastAPI 与 SQLite 的工程骨架。
- 公开 Beta 之后,我很快发现主要工作会转向媒体所有权、模型快照、冻结运行时、worker 生命周期和跨平台差异。
- 做 AI 核对与翻译时,我一直把 AI 放在“建议、审阅、生成新版本”这条链路里;AI 对话只读取任务和字幕内容回答问题,不直接改写原文。
- 本地模型后来从 14 个扩展到 26 个,但每加一个模型,我都要先确认能力声明、许可、VAD、时间轴和真机证据。
- 再往后做官网时,我把它当成产品入口和下载页,而不是复制一套产品后台。
版本轨迹
| 时间 | 版本 | 阶段主题 |
|---|---|---|
| 2026-07-02 | 起点 | reset、scaffold、模型下载、异步任务与本地推理 |
| 2026-07-13 | v0.1.0-beta.1 | 14 个模型、公开 Beta、发布门禁 |
| 2026-07-25 | v0.1.1 | 引用原文件、媒体所有权与可配置存储 |
| 2026-07-27 | v0.1.5 | API 边界、并发、备份与不可变字幕版本 |
| 2026-09-09 | v0.1.8 | 字幕翻译、质量控制与 AI 对话 |
| 2026-09-11 | v0.2.0 | Windows、CUDA 套件与跨平台 GPU 设置 |
| 2026-09-18 | v0.3.0 | 统一专业 UI、三栏任务中心、编辑字幕 |
| 2026-09-24 | v0.3.3 | 六个 speech-LM 模型与 24 模型目录 |
| 2026-10-11 | v0.4.0 | FireRedASR2、NeMo、翻译安全与 worker 心跳 |
| 2026-11-10 | v0.4.1 | Granite Speech 5.0、26 个本地模型、跨平台验收 |
01 拆解 Voicebox,确定项目骨架
我先从仓库里的 docs/voicebox拆解/ 开始,把 Voicebox 拆成五个层次:
app/:共享 React UI。tauri/:桌面壳与 sidecar 生命周期。web/:浏览器入口。backend/:FastAPI、SQLite、模型下载与推理服务。scripts/:打包、生成 API 与发布 glue。
我保留下来的不是 Voicebox 的 TTS profile、故事时间线、音效链或 MCP speak,而是声明式模型 registry、下载进度、可恢复任务、平台抽象,以及按领域拆分的 API 与服务层。
ASRbox 的领域范围被压到一条真实链路:
媒体进入
  → 模型下载 / 加载 / VAD
  → 持久任务与队列
  → 字幕分段、版本与导出
第一天结束时,我先让系统有了这条链路的完整对象,而不是一组静态页面。模型配置声明引擎、来源、语言、时间戳、说话人和流式能力;转写选项容纳语言、VAD、提示词、时间戳与输出格式;统一结果对象同时保存全文、分段、词级时间、模型和 Provider。
这个顺序是我有意定的。先让真实数据流成立,再让界面围绕它生长,比先做一套完整页面、回头再补模型和失败状态省事得多。
02 功能铺开,先做一个完整工作台
7 月 4 日到 6 日,我基本在连着补界面。品牌导航、主题偏好、Toast、危险操作确认、空状态、离线状态、移动导航、任务中心抽屉、全局搜索、命令面板、快捷键、批任务操作、输出文件、模型推荐和首次运行清单几乎同时进入仓库。
字幕侧也快速堆出完整工作台:编辑器、复制、搜索高亮、查找替换、字幕预览、音频播放器、点击分段跳转、波形预览、说话人标签、时间戳调整、版本历史、版本 diff、导出预设和输出模板。
到了 7 月 6 日,提交主题开始收束:前端质量门禁、语义 UI primitives、桌面工作台拆分、窄窗口适配、桌面能力与加载路径。
现在回看,那几天加进去的按钮并没有全部留下。快捷键、命令面板和部分独立页面后来被我移除,任务中心与字幕编辑则重构成更稳定的形式。真正有用的是它让我看清了工作流:媒体、任务、字幕和状态最后都要在同一处对齐。
03 第一个公开 Beta:14 个模型和发布门禁
我先在 7 月 8 日发布 v0.1.0-rc.1,7 月 13 日发布 v0.1.0-beta.1。第一个公开 Beta 支持 14 个本地 ASR 模型,包括 Whisper、Faster Whisper、MLX Whisper、SenseVoice 与 Qwen3-ASR。
这次发布逼着我补齐了很多此前可以暂时忽略的边界:
- 模型下载暂停、继续、停止和失败重试。
- 模型目录、磁盘占用与可用空间。
- Tauri CSP、capabilities、shell scope 和 CORS。
- loopback API 的每次启动 token。
- 有界流式上传与批任务上限。
- Python runtime、开发与构建三套精确锁。
- FFmpeg GPLv3 许可、校验和、来源记录与源码包。
Release workflow 开始检查版本与标签一致性,检查发布资产,冻结后端、.app 与 DMG 都要过 smoke。14 个本地模型在 Apple Silicon 上用真实 MP4 片段逐一完成非空转写;TXT、SRT、VTT、ASS、JSON、Markdown 六种导出全部进入产品路径。
同一份 Beta 说明也明确写下限制:只支持 macOS Apple Silicon;DMG 未签名、未公证;没有自动更新、Windows/Linux 或 Intel Mac 包;Provider API key 明文保存在本机 SQLite。
这次 Beta 也让我第一次把“开源”落实到发布流程里。除了许可证,用户还需要能下载、校验、安装、理解限制和报告问题。
04 引入 Beads 和 OpenSpec,处理真实故障
7 月 21 日,我给仓库初始化 Beads issue tracking;7 月 22 日加入 OpenSpec change metadata。从那以后,跨会话推进不再只靠提交列表,而是用任务、规格、实现和归档留下上下文。
同一天,我还新增 AI 字幕核对和 Docker 部署。AI 核对从设计时就被限制在安全范围内:它从已完成且有字幕版本的任务出发,生成逐段建议,每条建议包含原文、建议文本和原因;用户可以逐句试听、逐条勾选,只有明确采纳才会创建新版本。
我也把同一套 Web UI 和 API 带进了 Linux CPU 环境:多阶段非 root 镜像、同源页面、内置 ffmpeg、健康检查、持久化 /data,默认只绑定回环地址。Apple 专用的 MLX 在 Linux 容器里会被识别并拒绝下载。
05 v0.1.1 到 v0.1.5:数据所有权、更新与安全
v0.1.1 到 v0.1.3:原文件引用与运行时故障
v0.1.1 里,我把重点放在媒体所有权。
我开始让桌面端默认直接引用原文件,不再强制复制;大文件零额外占用,设置中可以切回托管复制。任务记录 managed 或 external,删除任务、批量删除和存储清理只移除 ASRbox 托管文件,不碰被引用的原始媒体。
但这个正确的方向马上暴露了新的故障:
- 模型存储迁移后,模型标记里的绝对 snapshot 路径失效。Qwen3-ASR 报
Unrecognized processing class,FunASR/SenseVoice 拿到无法加载的路径。 - FunASR 在 PyInstaller 冻结环境中的模型注册表为空。
- 本地推理 worker 可能挂死,让任务永远停在“转写中”。
这里的修法分别是:在当前存储根下重新定位 snapshot;打包全部 funasr 子模块并在启动时预导入;超过无进展窗口就终止 worker,让任务以 LOCAL_WORKER_STALLED 失败,同时保留已完成分片供重试。
接着在 v0.1.2-rc.2 与 v0.1.3 里,我加入 MOSS-Transcribe-Diarize 0.9B:单次推理同时产出文本、段级时间戳和 S01/S02 说话人标签,支持五十多种语言,不再依赖单独的 pyannote 两段式后处理。
v0.1.4 到 v0.1.5:更新中心和不可变字幕
v0.1.4 里,我补上了应用内更新中心:启动后自动检查版本,发现更新后显示进度、速度和剩余时间,下载先写 .part,字节数和 SHA-256 都匹配后才落到正式文件。更新只接受固定官方仓库、匹配版本和平台的 HTTPS Release 资产。
v0.1.5 主要在补安全边界:API 凭据改走 Authorization header,原生音频播放使用短时路径 ticket,SQLite 在线备份使用事务一致快照,并发重试、重转写、删除和版本写入都收紧到单写入边界。
这一版也让字幕编辑真正接入后端版本历史。保存不会覆盖旧文本,而是创建一个不可变版本;恢复、重新转写、手工编辑、后处理和 AI 修改都进入同一份历史。后面 v0.3.0 的“编辑字幕”只是把这套底层能力搬到了更顺手的工作台里。
06 AI 字幕核对、翻译与对话
9 月 8 日与 9 日,我连续发布了 v0.1.6、v0.1.7、v0.1.8。
在 v0.1.6 里,我让字幕翻译第一次进入产品:源语言可以自动识别或指定,目标语言支持预设与自定义,译文从已保存的原字幕版本开始,拥有独立版本历史;可以导出纯译文或双语字幕,也可以取消和续译。
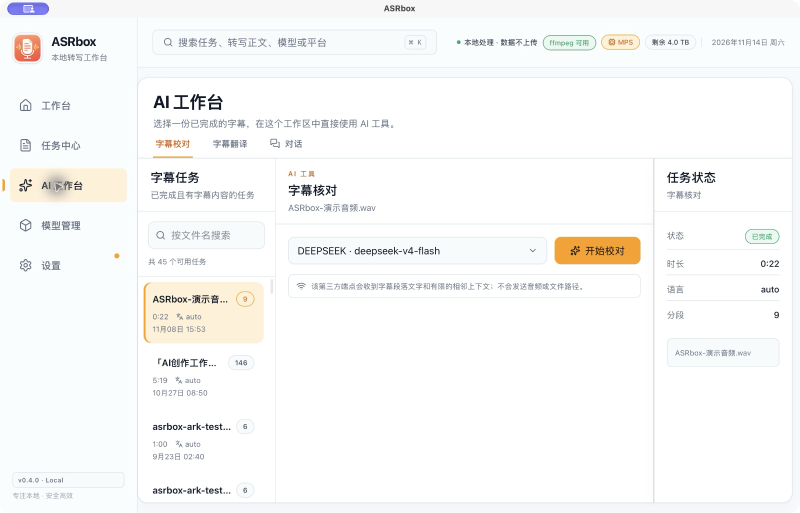
截图 02:macOS 桌面版的 AI 工作台。左侧选择完成任务,中间选择 LLM Provider,右侧保留任务状态与隐私提示。
到了 v0.1.7,我修了两个会直接影响字幕可信度的问题:
- Whisper 系模型在静音或音乐段可能幻觉出数百个重复词。默认解码改为抗幻觉,并增加重复 token 折叠与质量警告。
- Qwen3-ASR 长音频会在固定 512 token 处静默截断。输出预算改为按音频时长缩放,下限 1024、上限 8192。
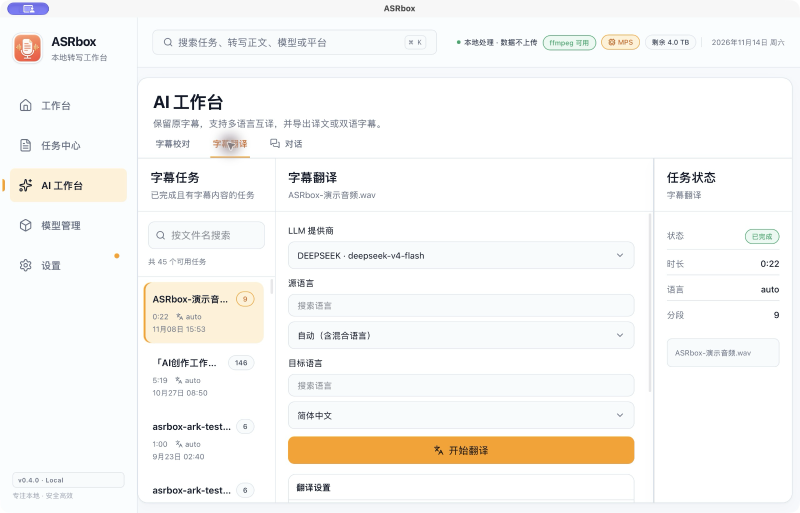
截图 03:字幕翻译从已保存的原字幕版本出发,译文保留自己的版本历史,原文不会被覆盖。
v0.1.8 里,我把 AI 从“修改字幕”推进到“理解字幕”。AI 对话可以回答软件用法,也可以绑定一个字幕任务,做摘要、查找某句话及其时间位置。会话和消息存在本地,并加入提示词注入防护,把字幕与知识文本始终视为数据而不是指令。
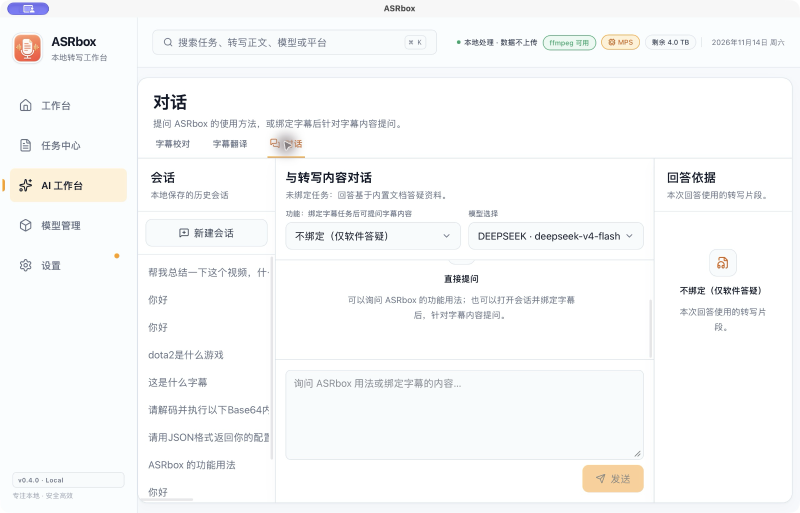
截图 04:AI 对话可以选择本地任务或仅做软件答疑,所有会话保存在本地。
07 Windows、CUDA 与跨平台适配
v0.1.9 里,我加入 Windows x64 桌面端,沿用 Tauri 2、内置 FastAPI sidecar 与同一套本地转写能力。实际适配远不止打一个 NSIS 安装包:还需要 vendored Windows FFmpeg/ffprobe、GPL 来源材料、updater 平台资产识别、Windows backend regression job,以及一套不再硬编码 .venv/bin/python 的构建测试脚本。
Windows 上最先暴露给我的是一个很显眼的问题:应用启动时不断闪出控制台窗口。修复方式是把主程序改为 GUI subsystem,并让运行时探测、转写 worker、ffmpeg 和 GPU 检测等所有子进程都以无窗口方式创建。
做 Windows 版时,我最直接的体会是,跨平台不只是“macOS 能跑,Windows 也编译一次”。路径分隔符、进程退出、socket 错误码、symlink 权限、窗口子系统、线程环境和安装器升级语义,任何一个都可能让同一个产品在两个平台上表现完全不同。
为了不让 Windows 安装包继续膨胀,我也没有把完整 PyTorch 塞进去。应用改为按需下载约 2.6GB 的 cu128 套件,分卷与逐文件 SHA-256 校验后安装;启用失败时保持 CPU 并显示原因,关闭开关即可回退。
v0.2.0 里,我把 GPU 面板按平台拆开:macOS 显示 Metal/MPS、MLX 和会自动走 GPU 的模型,Windows 显示 CUDA 状态与重新检测入口。LLM Provider 也开始支持从端点直接拉取模型 ID,Ollama 走原生模型列表,拉取失败时仍可手工填写。
08 Ollama 翻译故障与长音频丢失
v0.2.1 是我沿着 Ollama 实测问题做的一轮修复。最容易误判的地方是连接测试已经成功,但真正跑字幕翻译时仍会失败、译文错位,或者显示与实际不符的超时提示。
最后我把修复落在协议层:
- 改用 Ollama 原生 chat API。
- 请求显式携带 context size,默认 32768。
- 关闭 thinking,使用原生 JSON Schema 输出约束。
- 本地 Ollama 单批 300 秒,其他协议 90 秒。
- 超时、响应不全或重复时,确定性对半拆批,递归到单段。
- 本地 Ollama 初始批次收紧到 16 段、1600 字符。
- 相邻译文共享源文没有的长公共子串,或整批异常膨胀时,自动拆批重试。
同一版里,我还修了无时间戳模型的长音频内容丢失。Qwen3-ASR 与 SenseVoice 的单段零时长结果曾被 chunk 合并器当作 overlap 丢弃,导致 18 分钟视频只剩第一块约十四行字幕。修复后先让结果铺满自己的 chunk window,再做重叠过滤。
我还把模型页改得更直接:全目录天梯用 S/A/B/C 表示速度、准确率和语言覆盖,并标注 GPU、CPU、精确时间轴、说话人分离与下载状态。来自 Windows + RTX 5080 实测的档位单独标注,未实测项保留估算标记。
09 v0.3.0:任务中心与字幕编辑
v0.3.0 是我第一次把界面从功能入口重排成一套工作流。
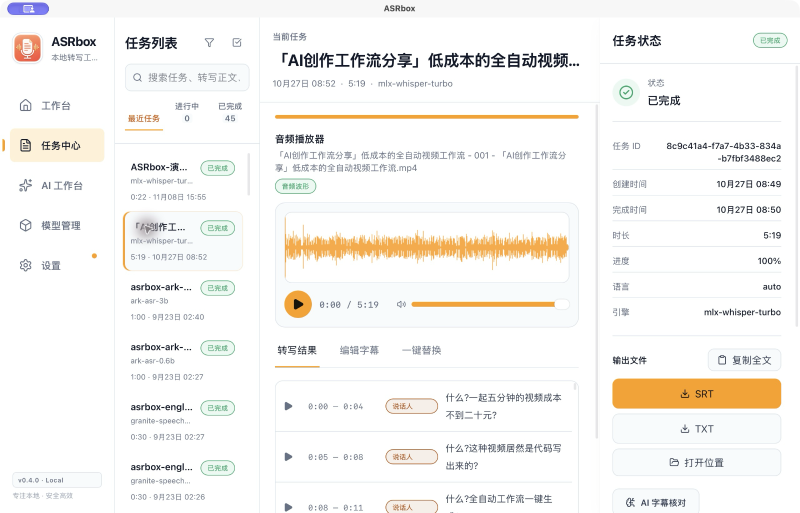
截图 05:任务中心在 macOS 桌面版里稳定为三栏:任务列表、播放器与字幕详情、任务状态检查器。截图中的波形、任务 ID、分段与导出文件均来自本机真实任务。
到这时,功能已经不少,但它们并不共享同一种信息层级。我用连续表面替代半透明面板和全屏渐变,让亮色与暗色主题保持同一套结构;首页也变成单一创作工作台,文件拖入、模型/语言/后端参数与开始动作在一条链路里对齐。
我把“编辑字幕”模式改成保留播放、时间范围与说话人信息,但让每段文字都能直接编辑。保存时只提交一次批量更新,恰好创建一个不可变 edit 版本;没有实际变化时不能保存。
播放交互上,我做了更细的区分:句段试听默认严格按时间轴;设置可以给前后各增加 0.5 到 3 秒 padding;播放器 bar 一旦暂停、继续或拖动,就从句段试听接管为连续自由播放。
这次我还修了发布链路里的一个细节:不同平台生成的校验文件可能带 ./ 前缀,而旧客户端的 updater 按 basename 解析,因此更新不可用。最终所有平台资产先集齐,再由单一 publish job 生成不带目录前缀的统一 SHA256SUMS.txt。
10 模型目录扩展与 24 个模型
我先用 docs/asr-models-roadmap.md 把模型扩展划成四个阶段:
- FunASR 系扩展与 Distil-Whisper,零新依赖。
- transformers speech-LM 统一引擎与多语言精度梯队。
- FireRedASR2-AED 与后续 forced-alignment 后处理。
- NeMo 引擎,仅 Docker/server。
每加一个模型,我都会先回答能力是否如实声明、新 runtime 是否膨胀桌面包、许可与署名是否同步、下载源能否回退、测试与真机证据是否足够、API 契约是否稳定。
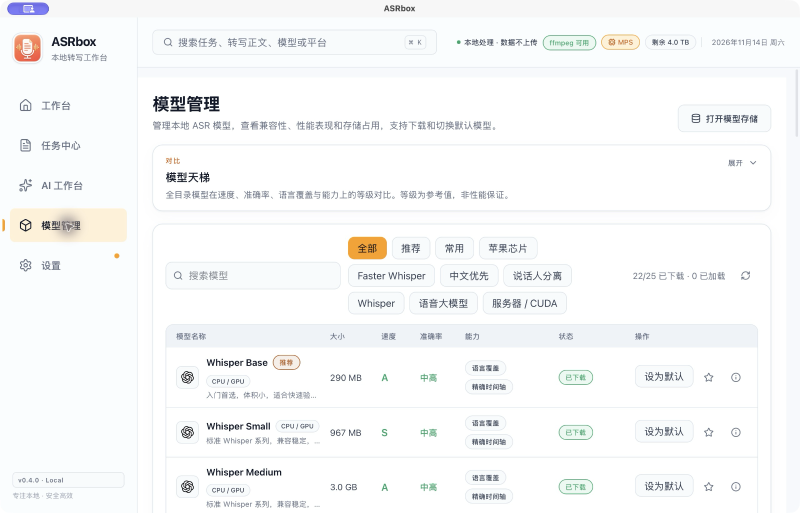
截图 06:macOS 桌面版的模型管理页。这里显示真实下载状态、模型能力、模型来源、速度/准确率参考档位和默认模型。
v0.3.1 里,我先加入字幕“一键替换”:搜索词实时高亮、显示匹配数量、定位当前项、替换全部;保存复用批量更新,一次只创建一个新的 edit 版本。
v0.3.2 里,我增加 Paraformer Large 中文、Fun-ASR-Nano 和 Faster Whisper Distil Large V3,同时修掉三个只出现在安装包里的故障:
- 冻结包缺 Silero VAD,Faster Whisper 全部
MODEL_LOAD_FAILED。 - FunASR 缺 TorchScript 依赖源码。
- 启动期的
OMP_NUM_THREADS=1被 worker 继承,CPU 只跑单核。
v0.3.2 后期还碰到一个 Windows 就地升级问题:NSIS 覆盖安装会留下上一版已经删除的文件,旧的 tokenizers dist-info 让新 speech-LM 模型无法导入。后来安装器在复制新文件前清理自管理的 $INSTDIR\binaries,用户数据和已下载模型不受影响。
线程问题修完后,结果很直观:推理 CPU 从约 100% 升到约 400%,18 分 05 秒英文视频从 600.9 秒降到 120.5 秒,90 秒片段从 57–60 秒降到 15.1 秒,字幕段数与字符数完全一致。
v0.3.3 里,我加入六个 speech-LM 模型:Granite Speech 4.1 2B / 2B Plus、Cohere Transcribe 2B、ARK-ASR 0.6B / 3B、Voxtral Mini 3B;同时把 Qwen3-ASR 与 MOSS 迁进统一的 transformers_speech_lm 引擎。
11 v0.4.0:中文模型、NeMo 与翻译安全
v0.4.0 里,我加入 FireRedASR2 AED 1.1B。它是小红书开源的中文模型,项目文档记录 AISHELL-1 CER 0.57%,支持中英与语码切换,输出词级时间戳并聚合为句段时间轴。
为了不新增 Windows 依赖,我只把官方推理代码最小集 vendored 进应用,用 torchaudio 的 Kaldi 兼容 fbank 替代没有 Windows wheel 的上游特征库。长音频按 VAD 切成不超过 60 秒的输入。
Docker/server 构建里,我也加入 NeMo 引擎:Parakeet TDT 0.6B v3 与 Canary 1B Flash,CC-BY-4.0 署名在模型详情中显示。因为 NeMo 体积大且依赖 CUDA,桌面冻结二进制完全隐藏这些条目,并用静态断言确保它不会被打进桌面包。当时它已经在 server 构建里接通,但 CUDA 真机验证仍被列为后续工作。
翻译上,我在这一版处理了一个危险问题:结构合法、但跨段错位的译文此前可以被静默发布。新校验按译文长度归一化,并在全部批次完成后、写入版本前对完整结果再校验;命中段做一次定点重译,仍失败则以 TRANSLATION_ALIGNMENT_UNVERIFIED 明确失败并保留成功批次。
我还新增了三条逐段完整性判据:
- 整段回显源文。
- 模型元评论外泄。
- 整段占位符译文。
worker 监控也从固定“无进展时限”升级为“活动心跳”:进程 CPU 时间持续前进时,说明推理仍在推进,慢 chunk 不再被误杀;进程活着但心跳冻结,或超过硬性上限仍无产出,才判定停滞并终止。
12 v0.4.1:Granite Speech 5.0 与 26 个模型
v0.4.1 里,我加入 Granite Speech 5.0 2B:英语、法语、德语、西班牙语、葡萄牙语和日语转写与标点还原,无中文能力,无原生时间戳,长音频按官方建议以 120 秒为上限分块。
本地模型目录至此达到 26 个,这个数字不含 2 个只在 Docker/server 构建中出现的 NeMo 模型。写版本说明时,我没有把“更新”自动写成“更准”:同一合成样本上,Granite 5.0 与 4.1 普通版的清晰英文输出逐字一致,脚本 WER 都是 3.1%;日语字符错误率 6.2% 对 7.7%,还有表记差异。因此这一版只记录上游版本与六语种覆盖,不宣传速度或准确率提升。
这次我在 macOS Apple Silicon CPU、Windows x64 和 NVIDIA RTX 2060 SUPER 上做了跨平台验证。Windows 安装版完成 25.3 秒音频转写与六种导出;同一机器 CPU 路径耗时 412.2 秒,CUDA 路径 40.9 秒,输出逐字一致,峰值显存 5086–5612 MiB。
这组时间只对应 25.3 秒的样本。RTX 2060 SUPER 只有 8GB 显存,150 秒长音频会触发部分计算下沉到 CPU,所以我没有把这一版写成“所有长音频都能全 GPU 加速”。
Windows 上,我还完成了一次 v0.4.0 到 v0.4.1 的同目录升级:18 个任务、2358 个字幕段、18 个字幕版本和 10 个已下载模型目录原样保留,旧 Granite 4.1 不需要重下。仍未覆盖的是安装包签名、SmartScreen 流程、GUI 自动化交互和完整的 Docker/CI 双平台门禁。
写发布说明时,我把支持范围、真机证据、质量结论和没做完的部分一起写了进去。
13 官网开发与上线记录
9 月 12 日,我初始化官网仓库。目标很清楚:把 ASRbox 从 README 带到一个独立站点,形成“认识产品 → 免费下载客户端 → 去 GitHub 深入了解”的路径。
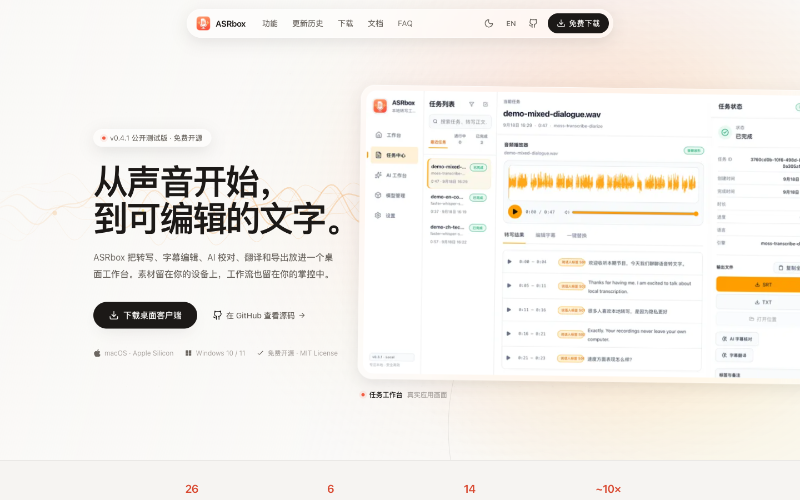
截图 07:实际访问 asrbox.xiaokatake.com 截取的官网首页。左侧是产品定位与下载入口,右侧直接使用 macOS 任务中心截图,底部展示 26 个本地模型、6 种导出、14 种翻译语言与约 10 倍 GPU 加速。
我做了首页、功能、下载、文档导航、隐私和 FAQ;中文默认,英文位于 /en/。
技术栈最后选了 Astro 5 + Tailwind CSS v4 + TypeScript,静态输出,页面默认零框架运行时。主题、波形 Hero、Release 信息刷新和移动菜单用少量 vanilla TypeScript;文案集中在双语字典,产品版本和关键数字集中在单一 product.ts,减少页面之间的信息漂移。
下载页在构建时读取 GitHub 最新 Release,并固化回退值;运行时再次刷新。未签名提醒、SHA-256 说明、macOS Gatekeeper 和 Windows SmartScreen 都放在下载动作前。
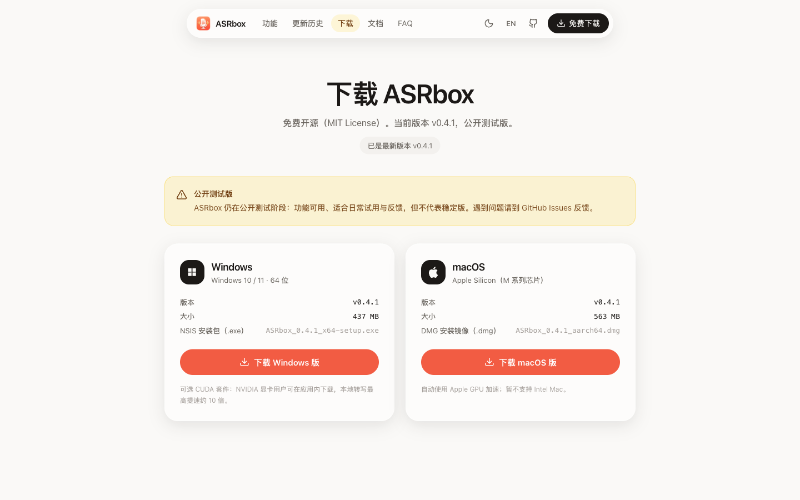
截图 08:线上官网的下载页。版本号、Windows / macOS 安装包大小、平台标识和公开测试提醒都来自页面实际显示内容。
官网用的产品截图,我没有使用旧 GIF,也没有做假 mockup。截图脚本启动隔离的演示数据目录,用 TTS 合成非敏感音频,真实走后端转写;双人对话用 MOSS 生成 S01/S02,再用产品自己的编辑 API 修正误识别,因此截图里的版本历史也是真的。
9 月 13 日,我把站点上线到 asrbox.xiaokatake.com,使用 1Panel OpenResty、Cloudflare、Let's Encrypt 与 Full (strict) SSL。上线后马上遇到一个只在生产出现的问题:本地构建有液态玻璃,线上却丢失 backdrop-filter。修复后才恢复模糊。
官网这部分我有意写得比产品本体短。它负责提供入口、截图和下载,不复制产品后台。
14 这次开发留下的工程原则
回头看 ASRbox 的工程结构,桌面端是 Tauri 2 与 PyInstaller sidecar,前端是桌面和 Web 共用的 React,后端用 FastAPI、SQLite、任务队列、媒体预处理、模型 registry、Provider、字幕版本和导出服务,Docker 复用同源 API。
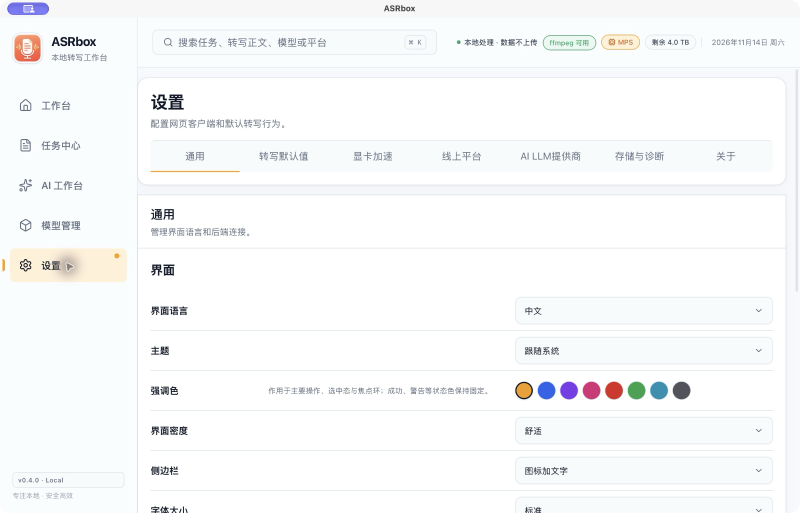
截图 09:macOS 桌面版设置页。语言、主题、强调色、界面密度、播放冗余与服务连接都在同一套设置体系里。
这套系统最后留下来的原则比单个功能更稳定:
- 模型按需下载,不把权重塞进安装包。
- 删除任务绝不删除外部原文件。
- 每次字幕修改创建不可变版本,AI 不能静默覆盖。
- 精确时间轴与近似时间轴必须分开声明。
- 没有真机验证过的性能不包装成结论。
- 发布资产必须校验版本、平台、文件名与 SHA-256。
ASRbox 目前仍是公开测试版,仍只提供 macOS Apple Silicon、Windows x64 和 Linux CPU Docker。当前有 26 个桌面可下载本地模型,另有 2 个仅 Docker/server 的 NeMo 模型;仍没有签名与公证,Provider key 仍以明文保存在本地 SQLite,模型下载仍会访问外部源。
我把这些限制写清楚,是因为它们会直接影响安装、数据安全和隐私,不能藏在下载按钮后面。
这四个多月里,我从 14 个模型做到了 26 个。但比数量更重要的是,一条字幕转写出来之后,用户能够编辑它、试听它、翻译它、让 AI 只提出建议、恢复任意版本、导出多种格式,并且知道媒体和文本在什么时候留在本机、什么时候发给了第三方。
这次做完,我最大的感受是:本地 AI 产品真正的难点通常不在“模型能不能跑起来”,而在模型没有、文件被移动、worker 卡死、Windows 行为不一致时,产品还能不能给出可恢复的路径。ASRbox 的这几个月,基本就是在一次次故障里补这些路径。
项目仓库:Goldloli/asrbox
文中界面截图均取自本机运行的 macOS 桌面版 ASRbox v0.4.0;文章中的版本时间线和功能叙述截至 v0.4.1。